以失败案例收紧标准
早期约70分钟录音曾被整理为4页口播,多个命例与推演被概述。复盘后将它识别为删节摘要,重新明确标准口播只去口癖,另有精简需求则单独制作。
把转写变成可追查的文稿生产流程
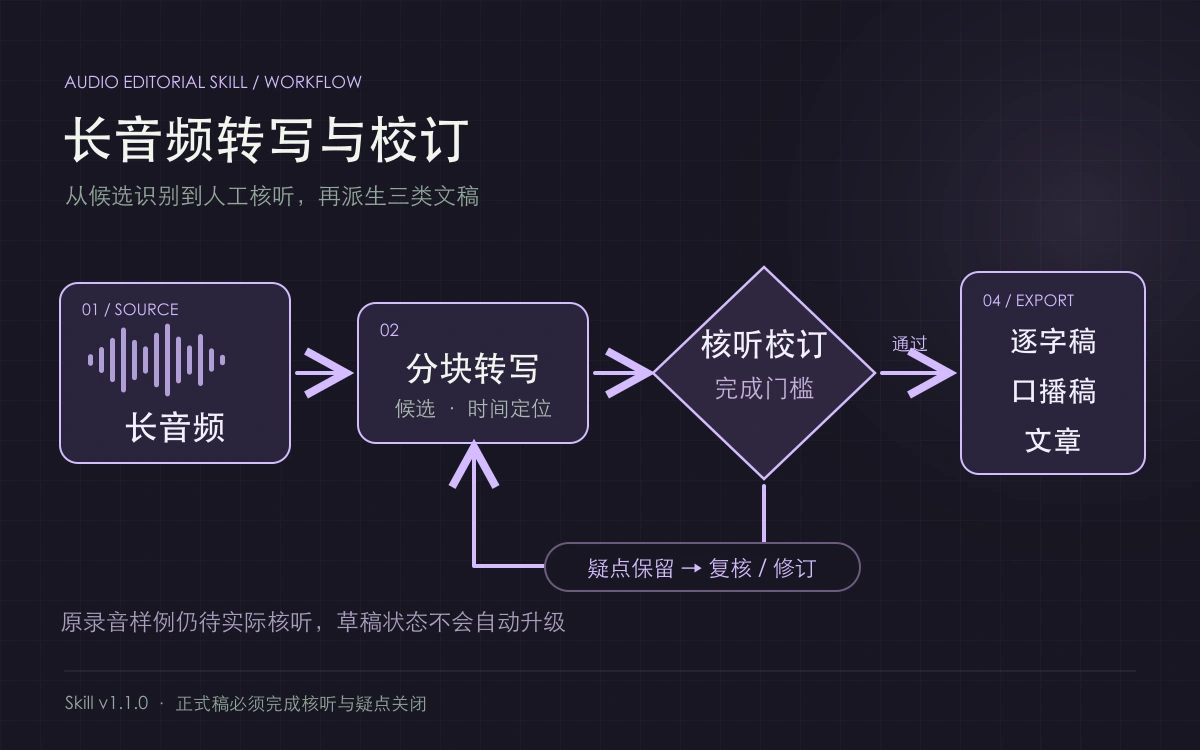
长音频转写与校订流程图 · 分块识别、核听校订门槛、返修回路与三稿导出 查看原图 ↗
设计分块转写、术语和数字校订、实际回听、疑点关闭、版本冻结及三稿导出检查。
帮助团队把转写、校订、核听与多种文稿输出组织为清晰的编辑流程。
将长音频转为带时间定位的候选逐字稿,衔接术语校订、逐段核对、口播稿与文章导出,保留来源与修改记录。
专业长录音会遇到口音、术语、缺图和识别循环。机器文本即使顺畅,也可能写错天干、数字、否定或自我更正;整理时只追求简洁,还会删掉讲解中的例子与条件。
我将这些问题整理为可复用Skill:保存候选和来源,按段校订逐字稿,再派生去口癖口播稿,文章另写。v1.1.0把实际核听、版本冻结和逐处差异检查纳入正式门槛,让状态对应真实完成范围。
长录音含专业词、口音和重复表达,机器文本即使通顺也可能失真,后续改写还容易丢失条件与原意。
工作流设计与工具整理
先在开头、中段、末段及术语密集处比较引擎,记录模型版本和设置。Qwen、Whisper和Breeze均为外部模型,局部比较不代替全长真值。
各音频独立保存哈希、参数和分块结果,检查空输出、循环与预算触顶。异常块只短段修复一次,仍有问题则保留待核状态。
逐段核词并完整回听,重点校对数字、专业术语、否定词和语序,形成可追溯的逐字稿。
口播稿从冻结逐字稿复制,仅删确定无义口癖或纯机械紧邻重复并调整标点,逐处记录差异。文章另按来源段落重组;完成状态检查后导出文档,再渲染查看中文与分页。
早期约70分钟录音曾被整理为4页口播,多个命例与推演被概述。复盘后将它识别为删节摘要,重新明确标准口播只去口癖,另有精简需求则单独制作。
领域词典的替换默认关闭,讲义与原典用于支持辨词候选。缺图、听不清或未回听的段落保留时间和问题,避免用理论上顺畅的文字覆盖原讲解。
文字交叉校对与实际听辨分别记录,核听范围和修订依据可追溯。全段听辨、疑点关闭后冻结逐字稿;草稿与正式稿在文件名、标题和清单中明确区分。
音频、模型或参数变化时不能无条件复用旧块;逐字稿修改后需重新生成口播并复核差异,避免只改派生稿而丢失来源。
欢迎交流这个项目中的产品思路、制作过程与交付经验。